Is een pentest verplicht?
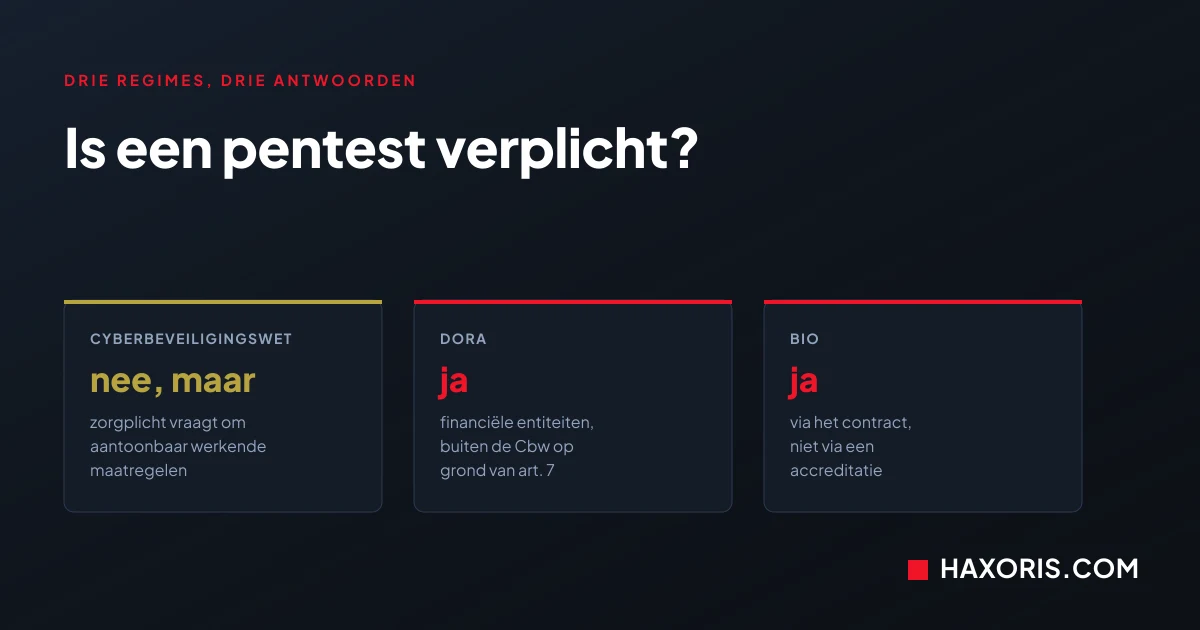
De Cyberbeveiligingswet schrijft geen pentest voor – de zorgplicht vraagt om aantoonbaar werkende maatregelen. Onder DORA en de BIO ligt dat anders. Per regime uitgelegd.
De Cyberbeveiligingswet schrijft geen pentest voor – de zorgplicht vraagt om aantoonbaar werkende maatregelen. Onder DORA en de BIO ligt dat anders. Per regime uitgelegd.
De AVG is de enige Europese regeling die periodiek testen met zoveel woorden noemt. Welke grondslag u nodig heeft, wat er in de verwerkersovereenkomst hoort, en wat een pentester met echte persoonsgegevens mag.
Sector, omvang en positie in de keten bepalen het antwoord. De drie vragen op volgorde, wat u moet regelen als het ja is, en waarom de eisen u ook zonder eigen plicht kunnen bereiken.
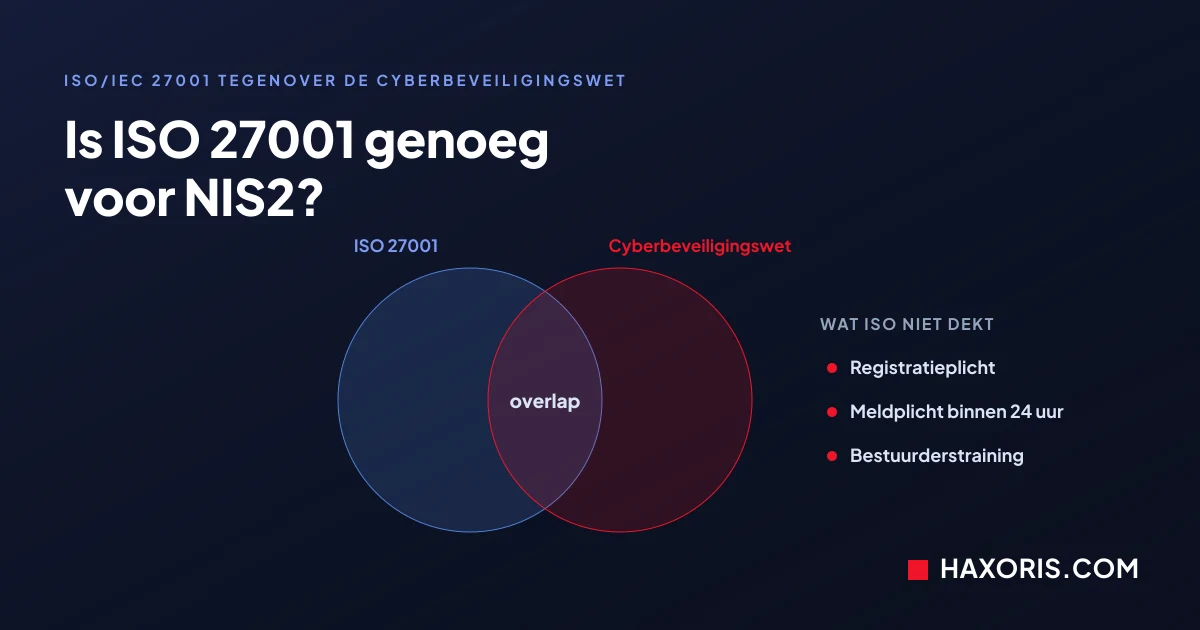
Een certificaat dekt een groot deel van de zorgplicht, en geen van de registratie-, meld- en bestuursverplichtingen. Waar de norm en de Cyberbeveiligingswet elkaar raken, en waar u zelf aan de bak moet.
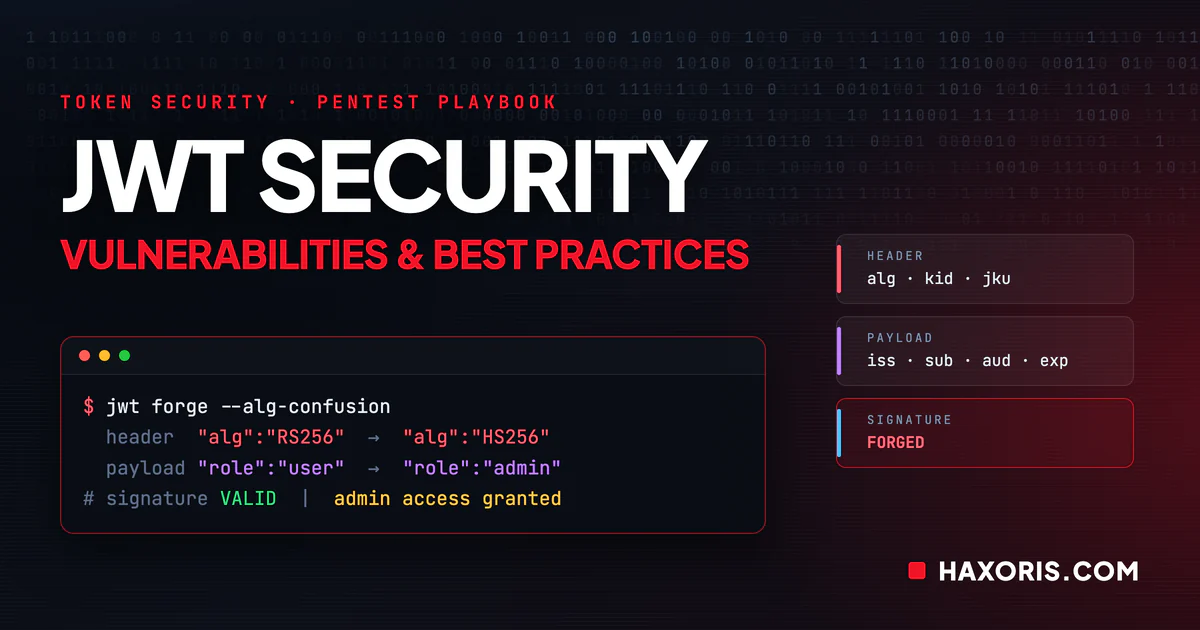
Hoe pentesters JSON Web Tokens breken - algorithm confusion, zwakke HMAC-secrets, kid- en jku-injectie, fouten in claimvalidatie - en de verdedigingen die dat tegenhouden.
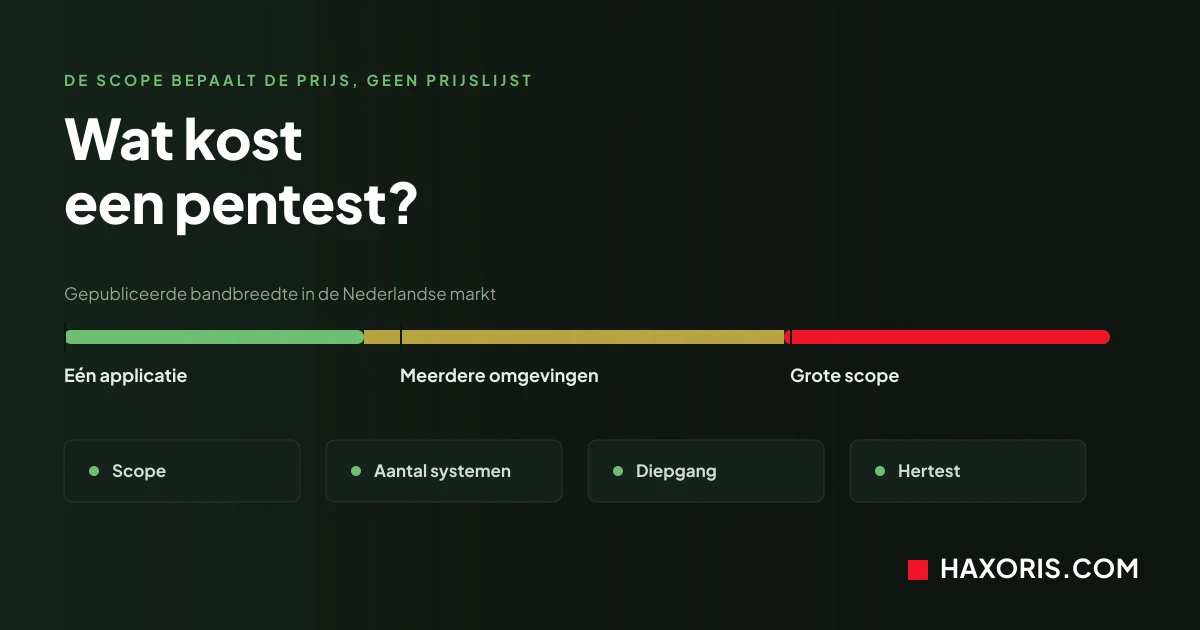
De prijs volgt uit de scope, niet uit een prijslijst. Welke factoren het bedrag bepalen, welke bedragen Nederlandse aanbieders publiceren, en waarom een offerte vóórdat de scope helder is een gok is.
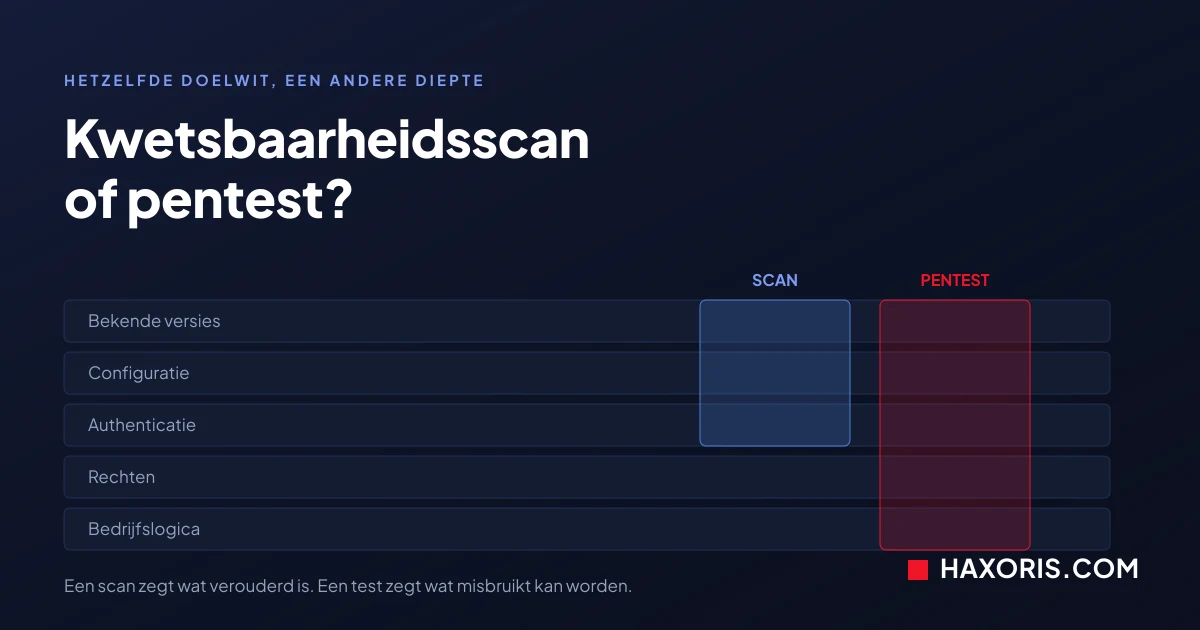
Een scan zegt wat verouderd is. Een test zegt wat misbruikt kan worden, en hoe ver iemand daarmee komt. Wat elk oplevert, wat het kost, en waarom vulnerability management geen van beide is.
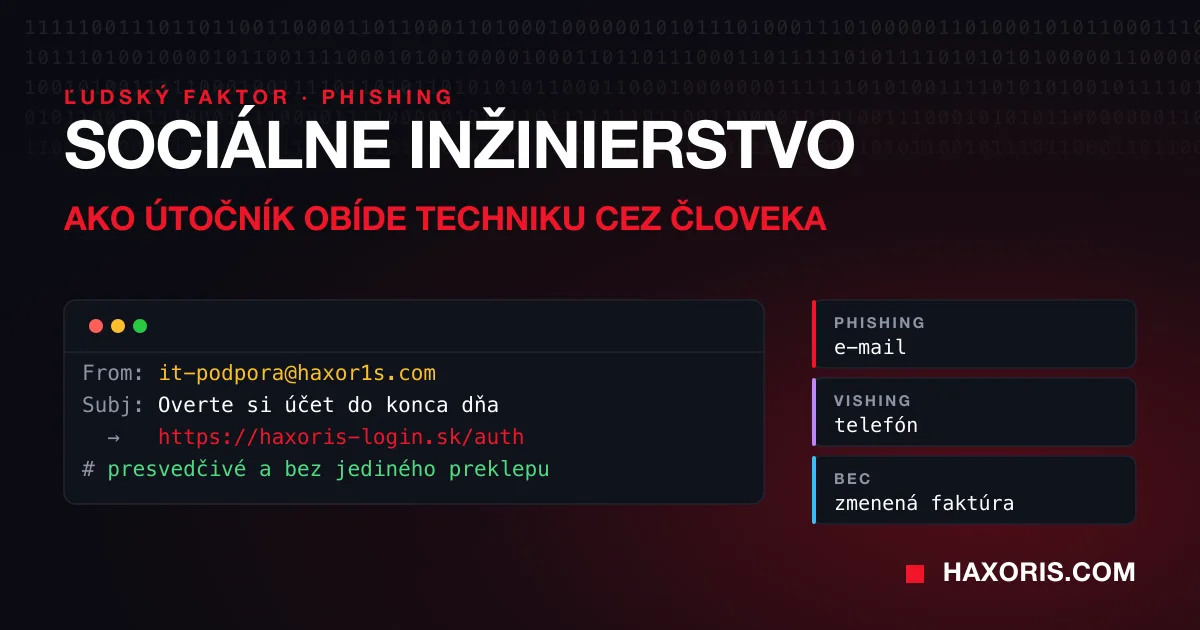
De goedkoopste weg naar binnen loopt niet via de firewall, maar via de mens. We leggen uit wat social engineering is, welke technieken aanvallers gebruiken en welke maatregelen in de praktijk standhouden.
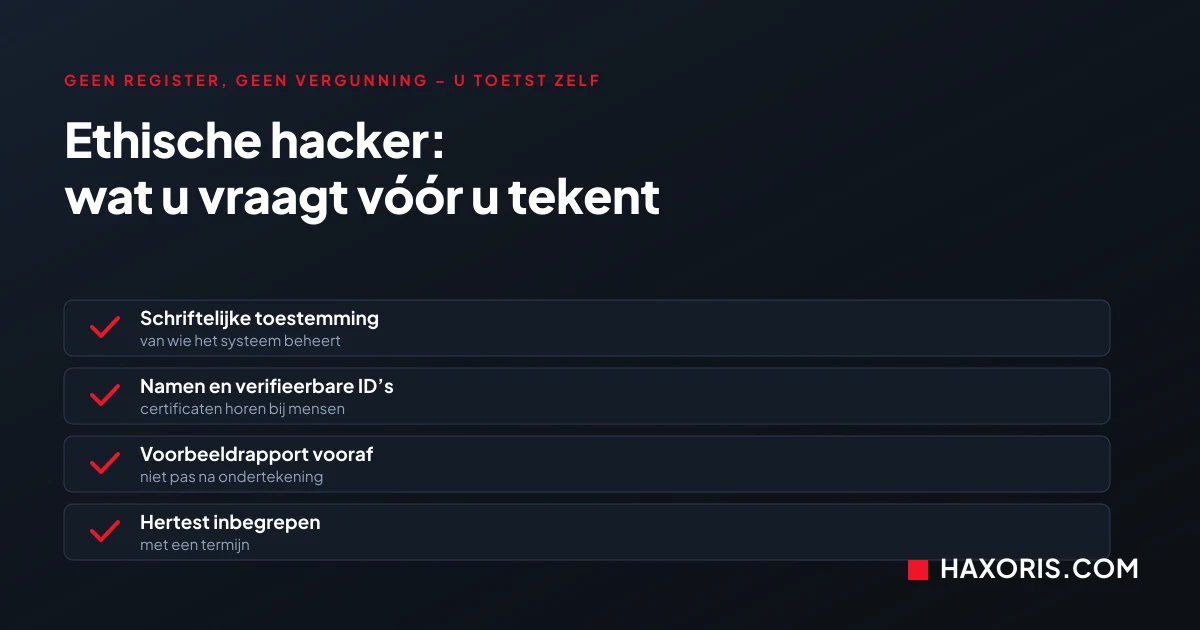
Nederland kent geen register en geen vergunning voor pentesters, dus het beoordelen van de leverancier is uw eigen werk. Waar u op let, wat er in het contract hoort en waaraan u een rapport herkent dat zijn geld waard is.
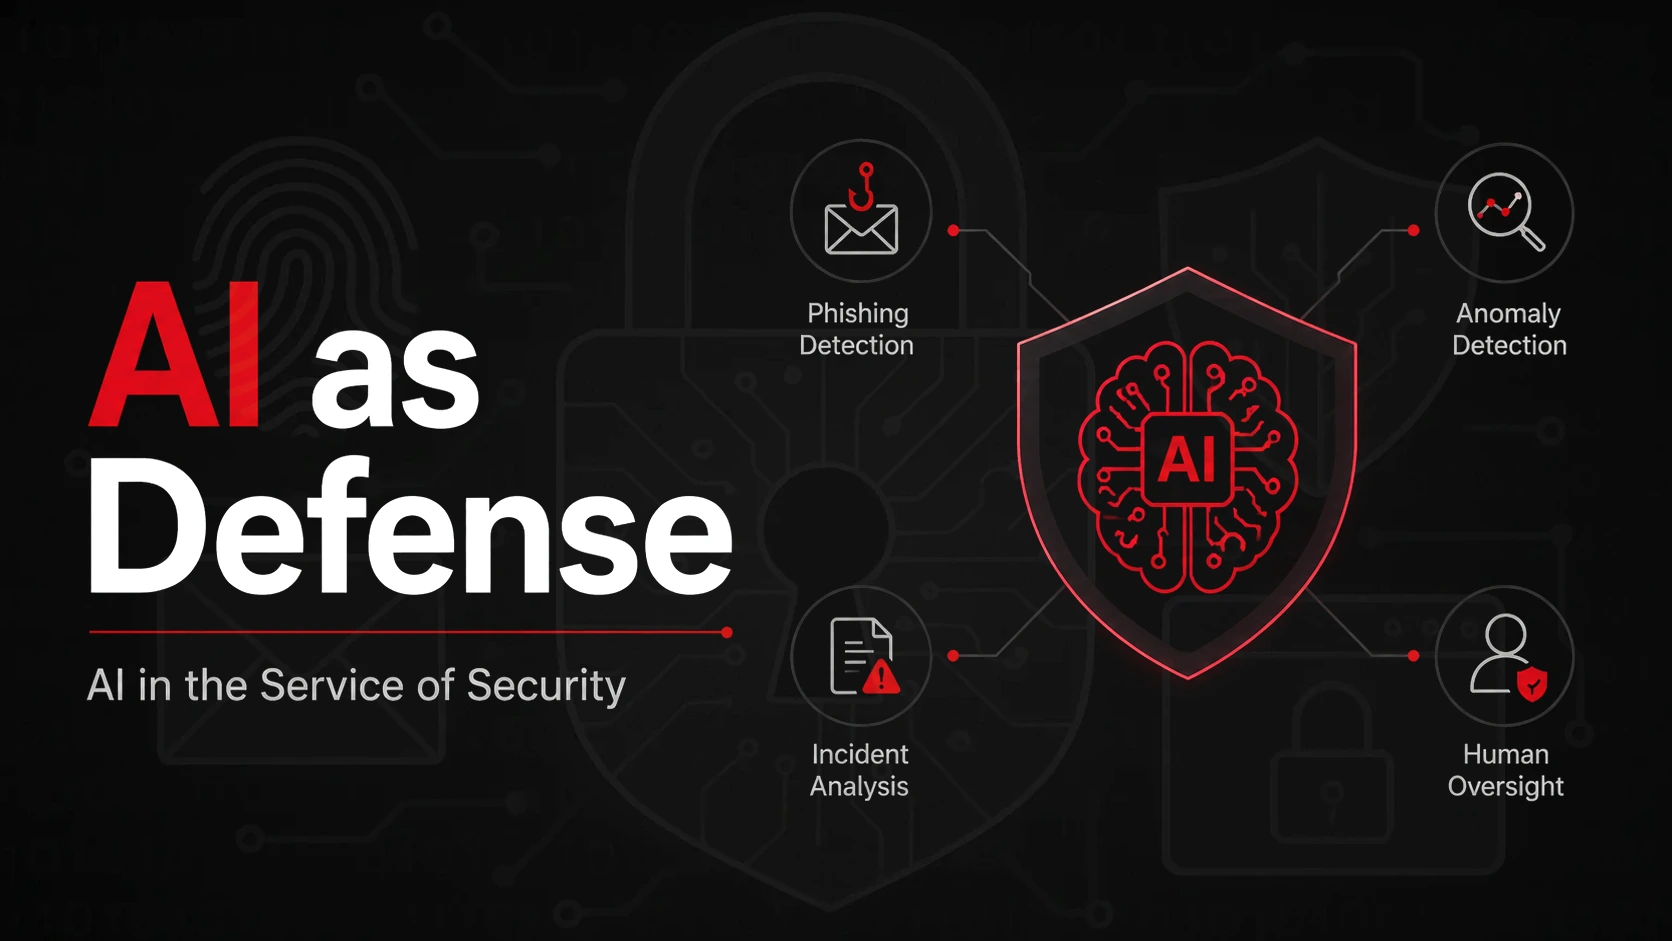
AI is niet alleen een dreiging. AI helpt phishing te detecteren, incidenten te analyseren, dreigingen te filteren en de reactie van securityteams te versnellen.
AI-phishing is overtuigender dan gewone oplichtingsberichten. Leer hoe u e-mailphishing, smishing, vishing en spear phishing herkent.
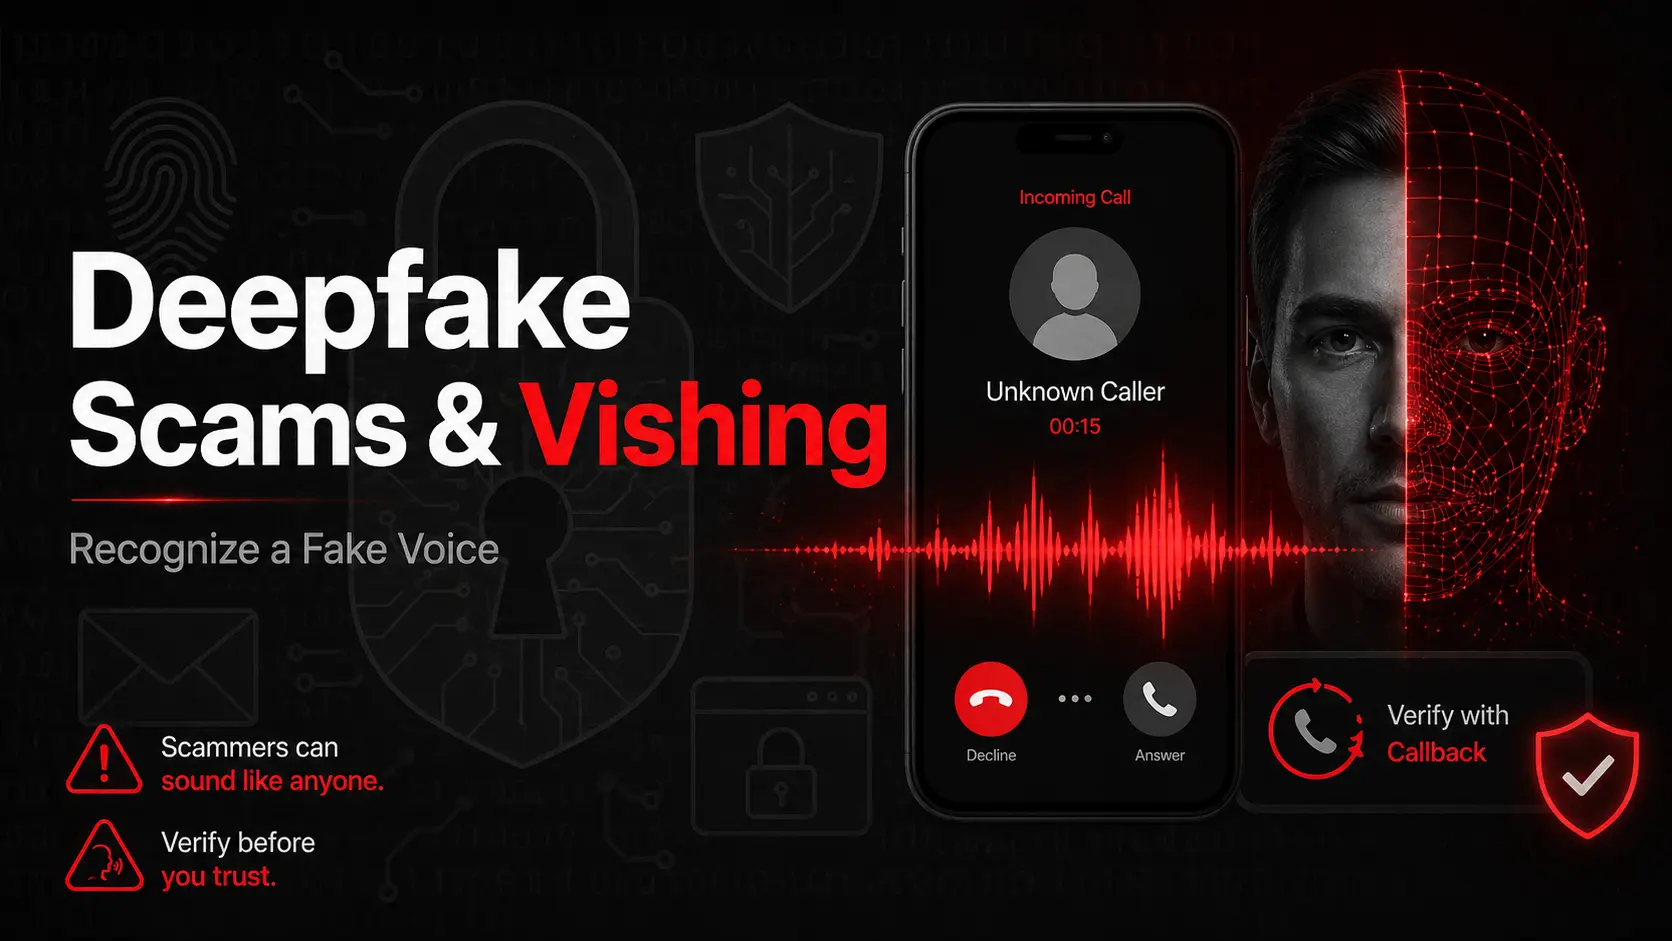
Een deepfakestem en vishing kunnen een directeur, collega of familielid imiteren. Leer de waarschuwingssignalen herkennen en verifieer verdachte telefoontjes.
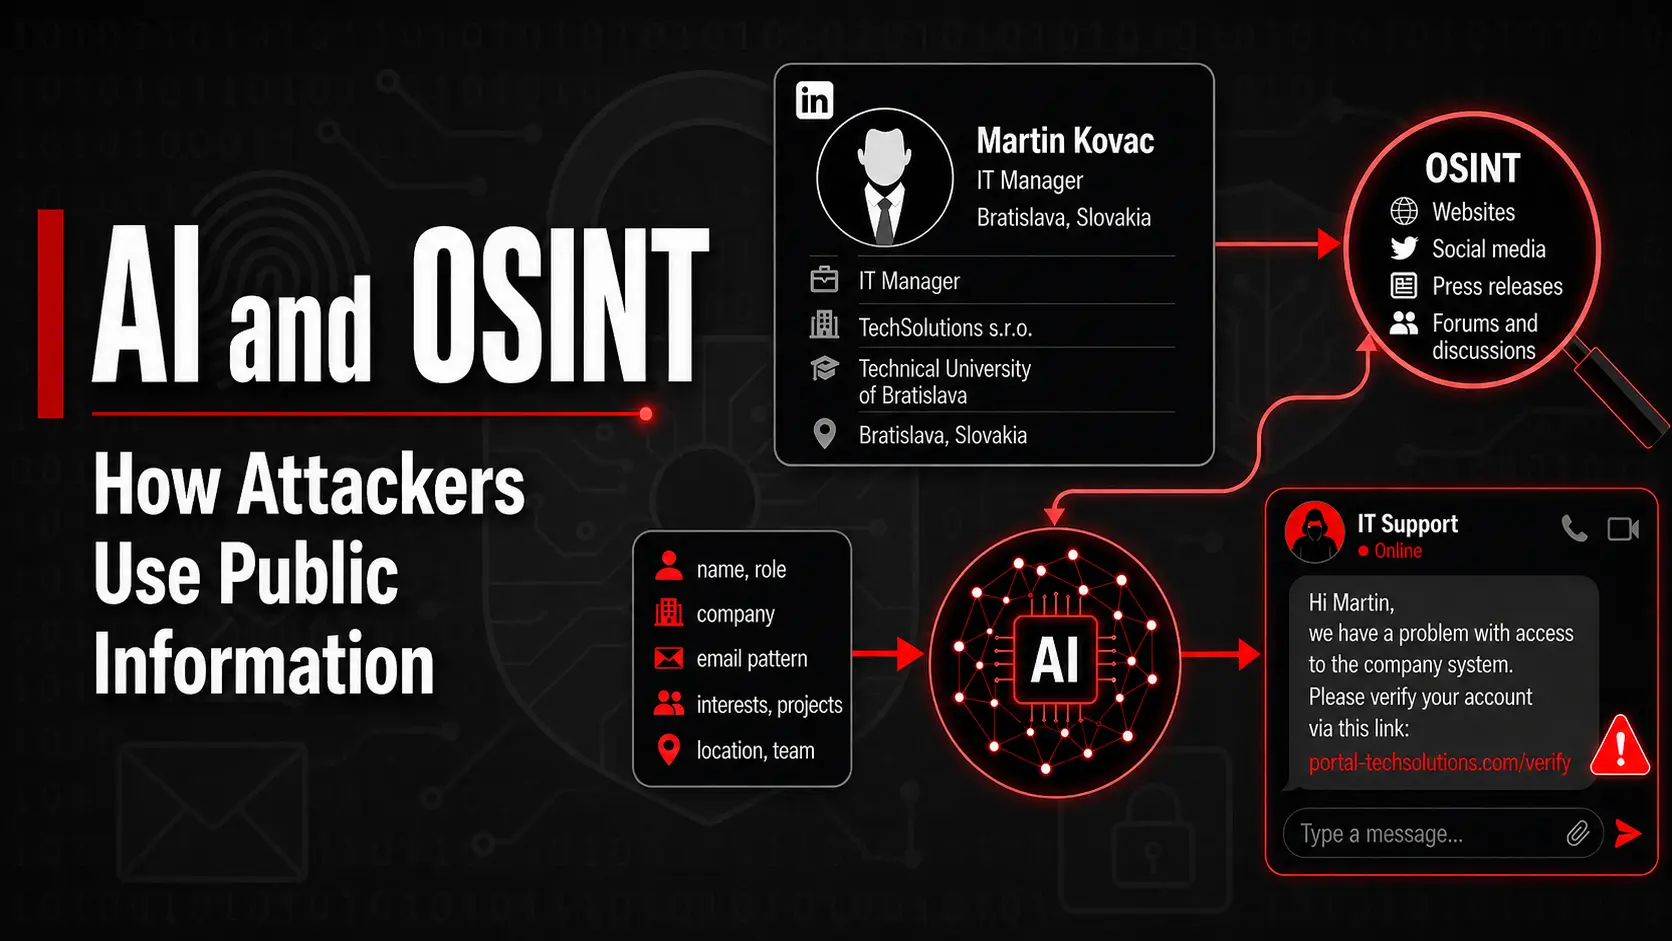
Aanvallers gebruiken LinkedIn, sociale media en bedrijfswebsites om gepersonaliseerde oplichting op te zetten. Lees hoe OSINT, AI en pretexting werken in echte aanvallen.
Kunstmatige intelligentie verandert phishing, deepfakefraude en het vinden van kwetsbaarheden. Lees hoe aanvallers AI inzetten en hoe u uw organisatie beschermt.
Wat het werk werkelijk inhoudt, hoe banken en cloudomgevingen worden getest, waarom Noord-Korea cryptovaluta steelt – en hoe modern phishing zo precies is geworden dat zelfs vakmensen bijna klikken.
Een lezing over red teaming – van de receptiebalie tot de domeincontroller – en een praktijkworkshop over het hacken van Android-applicaties volgens de OWASP Mobile Top 10.
Een gecontroleerde aanval met schriftelijke toestemming, een afgesproken scope en een vast tijdvenster. Wat een pentest is, hoe die verschilt van een kwetsbaarheidsscan, wat de prijs bepaalt en wat de Nederlandse wet werkelijk van u vraagt.
Is uw AI-chatbot werkelijk veilig? Aanvallen zoals prompt injection kunnen gevoelige gegevens blootleggen en het gedrag van het model sturen. Vaak is één slim geformuleerde zin genoeg om de beschermingslagen te doorbreken en het model zijn oorspronkelijke regels te laten negeren. In dit artikel leest u welke aanvalsklassen er bestaan, waarom een firewall of invoervalidatie ze niet tegenhoudt en wat een gespecialiseerde pentest van een LLM-integratie concreet onderzoekt.
Acht weken zonder beperkingen: een phishingcampagne die 260 inloggegevens opleverde, een fysieke inbraak met een rogue implant, en domeinbeheerder via een verkeerd geconfigureerde certificaatautoriteit. Geen enkele verdediging sloeg alarm.
Een pentest maakt van een formele cybersecurity-audit een echte zekerheid. Ontdek waarom auditors leunen op onafhankelijk geverifieerde bevindingen en hoe u zwakke plekken herstelt voordat ze een incident worden.
Ons onderzoek bekeek hoe generatieve AI-modellen kunnen helpen bij het opsporen van kwetsbaarheden en het analyseren van securitylogs. AI wint tijd, maar levert ook onterechte meldingen en kosten op. De conclusie: AI versterkt de analist, maar vervangt hem niet.
Een gastcollege over OWASP-methodieken en beveiligingslekken in PHP-applicaties aan de STU in Bratislava, met een live demonstratie van een SQL-injectie.
Ethisch hacken mag ook luchtig: over CVE's, beveiliging in het bankwezen en verhalen uit de praktijk, te gast in de Slowaakse podcast Buzzworld.
Hoe ethische hackers systemen legaal testen: toestemming, scope en verantwoorde melding. Een podcastaflevering over hacken dat wél mag.